PixelUMM是什么
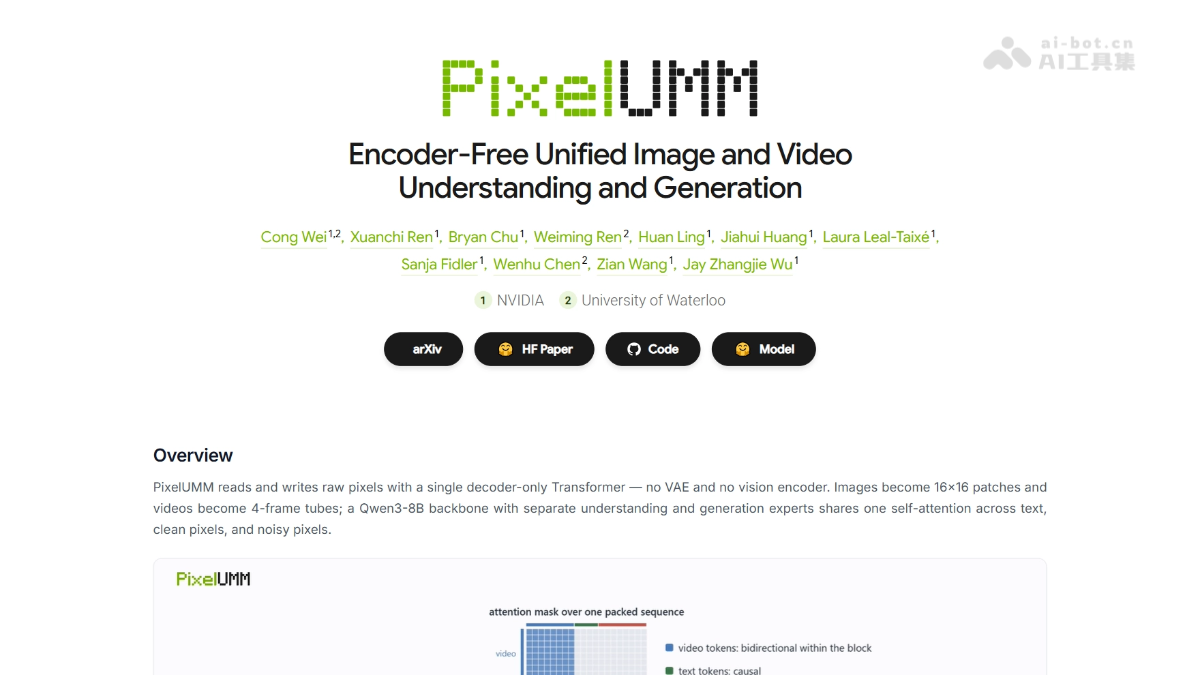
PixelUMM 是 NVIDIA 与滑铁卢大学联合推出的无编码器统一多模态模型,核心突破是彻底移除 VAE 和视觉编码器,用单个 Decoder-only Transformer直接在原始像素空间读写图像与视频,理解和生成共享同一解码器与自注意力。图像按 16×16 patch、视频按 4 帧 tubelet 切分,代码已开源。
PixelUMM的主要功能
文本生视频(T2V):支持生成最高 832×464、96 帧、24fps 的 4 秒视频,画质与主流视频扩散模型相当。
文本生图像(T2I):在同一模型内直接生成图像,无需单独的图像分支或解码器。
图像理解:可完成 VQA、OCR、图表、文档等 21 项图像理解任务,达到 8B 级 VLM 的平均水平。
视频理解:支持 MVBench、Video-MME 等视频问答基准,提供 dense 和 sparse 两种输入模式。
图生视频(I2V):将干净的首帧图像作为条件注入理解专家,即可生成后续视频,无需 VAE 编码条件帧。
视频编辑:以输入视频为视觉条件,通过多模态上下文条件机制实现编辑类任务。
PixelUMM的技术原理
- 无编码器架构:PixelUMM 彻底移除了传统统一模型中的 VAE 和视觉编码器,图像直接切分为 16×16 patch、视频切分为 4 帧 tubelet 原始 RGB 像素形式输入,输出同样由线性头直接回归像素,整个流程没有 latent 空间的编解码损耗,实现真正的端到端像素读写。
- MoT 共享注意力结构:模型用 Qwen3-8B 为骨干构建 Mixture-of-Transformers:理解专家和生成专家各自拥有独立的 FFN,共享同一套 self-attention,使文本、干净像素与噪声像素能在同一注意力空间内交互,在一个模型内统一理解与生成。
- 像素空间扩散训练:生成任务在像素空间直接做 flow-matching 式训练,消融实验表明像素空间与 VAE 空间的梯度范数几乎一致,但像素空间训练更稳定,且压缩率实验证实 16×16 patch、4 帧 tubelet 是学习难度与效率的最优平衡点。
- 多模态条件注入机制:参考文本条件、参考图像、输入视频等”干净条件”统一走理解专家,待生成的噪声 token 走生成专家,两者在共享注意力中融合,扩展了 SenseNova-U1 的 encoder-free 条件方式到图生视频与视频编辑,消融显示设计不损伤理解能力,四项视频基准提升 0.89–3.49 分。
- 线性输出头与卷积头消融:默认采用轻量线性输出头,会引入 16 像素网格伪影;实验对比 Wan 式上采样卷积头与 PixelShuffle 头,证明卷积头可消除伪影,其中时间优先的 PixelShuffle 是训练损失与伪影抑制间的最佳折中,切换头需要重新训练。
如何使用PixelUMM
- 克隆仓库:
git clone https://github.com/nv-tlabs/PixelUMM,按ENVIRONMENT.md配置 CUDA 环境。 - 下载权重:从 Hugging Face 的
nvidia/PixelUMM下载默认 checkpointS8-F22-R05,并按CHECKPOINT.md下载 Qwen3-8B 的配置和 tokenizer 文件。 - 设置路径:配置
PIXELUMM_CKPT、PIXELUMM_QWEN_DIR、PIXELUMM_OUTPUT三个环境变量指向本地绝对路径。 - 校验 checkpoint:先运行
check_checkpoint.py检查权重完整性和张量兼容性。 - 申请安全审核权限:到 Hugging Face 申请
nvidia/Cosmos-1.0-Guardrail的访问权限并登录。 - 运行推理:用
inference.py分别指定--task t2i / t2v / image-vlm / video-vlm,配合 prompt、分辨率、帧数等参数生成图像、视频或输出理解结果。 - 批量生成(可选):使用
inference_batch.py配合 YAML prompt 文件批量跑任务。 - 玩具训练(可选):按
TRAIN.md下载 toy 数据集,用train_toy.py在 F22 checkpoint 基础上跑四任务训练示例。
PixelUMM的核心优势
彻底无编码器架构:移除 VAE 和视觉编码器,直接在原始像素空间读写,消除 latent 空间编解码带来的信息损耗与伪影来源。
统一理解与生成:单个 decoder-only Transformer 同时完成文生图、文生视频、图像理解、视频理解四大任务,理解专家与生成专家共享同一自注意力。
架构简洁、推理直接:输出由轻量线性头直接回归像素,无需额外解码器,生成链路更短。
条件注入灵活高效:参考图像、输入视频等干净条件走理解专家即可实现图生视频和视频编辑,消融证明该设计不损伤理解能力。
训练规律清晰可扩展:8B 模型达到同等损失仅需 1.7B 模型约三分之一的训练步数,规模化收益明确。
PixelUMM的项目地址
- 项目官网:https://nv-tlabs.github.io/PixelUMM/
- GitHub仓库:https://github.com/nv-tlabs/PixelUMM
- HuggingFace模型库:https://huggingface.co/nvidia/PixelUMM
- arXiv技术论文:https://arxiv.org/pdf/2609.38597
PixelUMM的同类竞品对比
| 对比维度 | PixelUMM(NVIDIA × 滑铁卢大学) | BAGEL(字节跳动) |
|---|---|---|
| 核心架构理念 | Encoder-Free:彻底移除 VAE 和视觉编码器,像素空间端到端读写 | Encoder-Based:Wan 系 VAE + SigLIP 视觉编码器,latent 空间扩散生成 |
| 骨干网络 | Qwen3-8B | Qwen2.5-7B-Instruct |
| 总参数量 | 15.2B(MoT,稠密激活) | 14B MoE(每 token 约 7B 激活) |
| 视觉 token 化 | 图像 16×16 patch,视频 4 帧 tubelet(p16/t4),原始 RGB 直接输入 | VAE 压缩至 latent 后用 patchify 投影 |
| 输出方式 | 轻量线性头直接回归像素(12.6M 参数) | VAE 解码器还原像素 |
| 支持任务 | T2I、T2V、图像理解、视频理解、I2V、视频编辑 | T2I、T2V、I2V、图像理解、图像编辑、视频编辑 |
| 图像理解 MMMU | 41.67 | 55.30(大幅领先) |
| 图像理解 AI2D | 80.12 | 89.20 |
| 图像理解 ChartQA | 82.96 | 78.50 |
| 图像理解 CountBench | 94.30 | 82.50 |
PixelUMM的应用场景
短视频内容创作:输入一句文案直接生成 4 秒 24fps 视频,适合社交媒体快速产出素材。
图生视频与视频编辑:用首帧或原视频为条件生成/修改内容,可用于电商产品动态展示和影视预演。
长视频理解与问答:对输入视频做描述、摘要和时序推理,适用于内容审核、素材检索和会议纪要。
文档与图表解析:OCRBench 78.0、DocVQA 90.4 的成绩可支撑票据识别、报表问答等企业文档智能化场景。
相关文章