MOSS-Image是什么
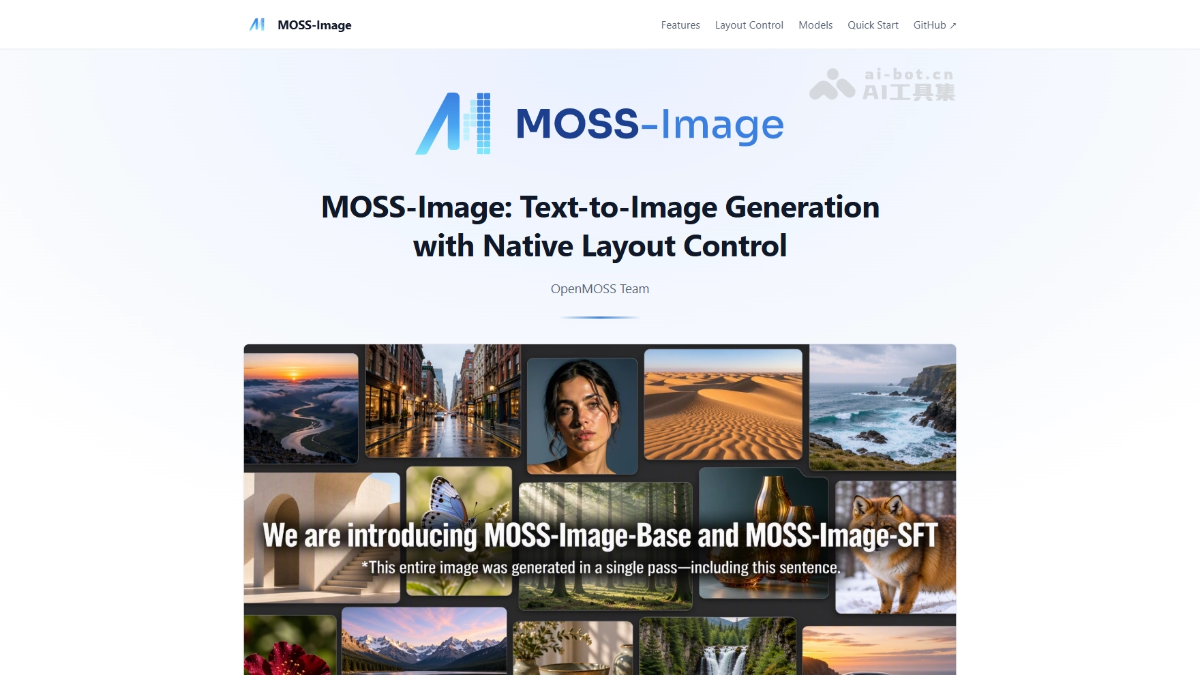
MOSS-Image是模思智能与 OpenMOSS 联合开源的文生图模型,核心是5B参数DiT主干,结合冻结的Qwen3.5-9B文本编码器和FLUX.2 VAE,权重采用Apache-2.0。MOSS-Image强调训练数据剔除AI生成图以减弱AI味,支持中英文长文本渲染、JSON Layout/Bounding Box布局控制和最长4096 tokens提示词。MOSS-Image带动8步/4步加速、INT8/GGUF量化与多风格LoRA等社区生态。
MOSS-Image的主要功能
自然语言文生图:输入描述可生成照片级写实、动漫、插画等风格图像。
中英文文字渲染:优化密集文本与长文本生成,尽量保留换行等排版结构。
原生 Layout 控制:用 JSON 指定 summary、items、text 与 bbox,约束标题、物体和文字位置。
长 Prompt 支持:最长支持 4096 tokens,适合多主体、空间关系、镜头与风格并存的复杂需求。
生态与部署:提供 Diffusers、Gradio、ComfyUI、SGLang、vLLM-Omni 等路径,并衍生加速、量化与 LoRA。
MOSS-Image的技术原理
模型架构:采用从零预训练的单流扩散 Transformer,核心 DiT 主干为 5B;文本条件由冻结的 Qwen3.5-9B 提取,图像潜变量经 FLUX.2 VAE 编解码,文本与图像潜变量在统一扩散框架中联合建模。
布局控制:将 summary、caption、items、label 与 bbox 编译为结构化提示,坐标采用 abs_centralized 像素制、yxyx 格式,让对象、文字与空间位置成为显式条件非仅靠自然语言暗示。
数据策略:训练前做去重与质量筛选,剔除 AI 生成图像,保留真实图像多样性,并标注水印、模糊等属性,降低“AI 味”并提升画面自然度。
文字与长提示优化:面向海报、电商等设计任务强化密集/长文本渲染与 4096 tokens 条件输入,使复杂指令、文字内容和空间关系能同时进入生成过程。
微信关注回复“开源”,加入AI开源项目交流群
如何使用MOSS-Image
准备环境:使用 Python 3.10+ 与 NVIDIA GPU,安装匹配 CUDA 的 PyTorch。
拉取代码:
git clone https://github.com/OpenMOSS/MOSS-Image.git并进入目录创建虚拟环境。安装依赖:激活环境后执行
pip install -r requirements.txt。加载模型:用 Diffusers 以
custom_pipeline="pipeline_moss_image"和trust_remote_code=True加载 Base/SFT 权重。配置精度:建议 DiT 用
bfloat16、VAE 用float32,再pipe.to("cuda")。普通生图:传入自然语言 prompt,设置宽高、
num_inference_steps=50、guidance_scale=3.0等参数生成。布局生图:把 summary/items/bbox 写成 JSON,作为 prompt 输入以控制文字和物体位置。
复杂提示词:需求较细时用 Prompt Enhancer 把创意扩成详细 caption 或结构化 Layout。
ComfyUI 使用:在 ComfyUI Manager 搜索并安装 MOSS-Image 插件,再加载示例工作流运行。
低显存优化:显存紧张时选 INT8/GGUF/MLX、8步/4步加速,或开启分块/卸载策略。
MOSS-Image的测评表现
文字渲染 LLTB:Mean-6 文本覆盖率 96.3%,为参评开放权重模型第一。
布局控制 7Bench:目标定位 mIoU 0.88,布局 AUC 0.70。
真实设计盲评 RLA:短提示条件下 Elo 点估计 1698.70,列第二,仅次 GPT Image 2;统一增强提示词组 Elo 1807.34,领先 ERNIE Image、SenseNova U1。
MOSS-Image的核心优势
画面更自然:训练数据剔除 AI 生成图,减弱“AI 味”和过度精致感。
文字渲染强:针对中英文密集/长文本优化,LLTB Mean-6 覆盖率达 96.3%。
布局可控:支持 JSON Layout 与 Bounding Box,明确指定文字、物体及空间位置。
长 Prompt 友好:最长 4096 tokens,适合复杂主体、关系、镜头与风格描述。
轻量易改:5B 主干便于微调,Apache-2.0 权重加速社区 LoRA 与衍生模型。
上手路径多:支持 Diffusers、Gradio、ComfyUI、SGLang、vLLM-Omni 及 API。
设计场景实用:面向海报、电商图、排版类任务,盲评成绩接近或领先部分商用模型。
MOSS-Image的项目地址
- 项目官网:https://openmoss.ai/MOSS-Image/
- GitHub仓库:https://github.com/OpenMOSS/MOSS-Image
- HuggingFace模型库:
- https://huggingface.co/OpenMOSS-Team/MOSS-Image-SFT
- https://huggingface.co/OpenMOSS-Team/MOSS-Image-Base
- 技术论文:https://github.com/OpenMOSS/MOSS-Image/blob/main/paper/MOSS_Image_Technical_Report.pdf
MOSS-Image的同类竞品对比
| 维度 | MOSS-Image | FLUX 3 Image Klein |
|---|---|---|
| 核心定位 | 可控设计向文生图:文字、排版、布局优先 | 通用高质量文生图基线,强调画质与风格 |
| 训练取向 | 剔除 AI 生成图,强调更自然、低“AI 味” | 公开细节有限;社区多关注其画质与成熟度 |
| 文字渲染 | 重点优化中英文密集/长文本,LLTB 覆盖率 96.3% | 可用,但设计排版类长文本通常需更多提示与工作流配合 |
| 布局控制 | 原生 JSON Layout + Bounding Box,适合海报/电商构图 | 更依赖自然语言、Control 类插件或外部工作流约束 |
| 长 Prompt | 支持最长 4096 tokens | 视版本与接口而定,长指令遵循通常不如其画质受关注 |
| 生态微调 | 5B 主干、Apache-2.0,LoRA/量化/加速衍生很快 | 生态成熟、第三方工具多,但可控设计链条需自行搭建 |
| 部署门槛 | 12–24GB 显存分层可用,社区量化方案多 | 轻量友好,但完整高画质方案对显存与调参仍有要求 |
| 主要短板 | 图生图/编辑链路弱,复杂姿态与背景融合仍可能翻车 | 原生排版、文字与结构化布局控制不是最核心卖点 |
MOSS-Image的应用场景
海报设计:用 JSON Layout 固定标题、主视觉和辅助元素位置,快速生成排版可控的宣传海报。
电商图制作:约束商品、文案、价格标签与背景区域,生成适合详情页和主图的营销视觉。
社媒内容配图:把长 Prompt 转成符合品牌调性的写实或插画内容,用于公众号、小红书与广告物料。
动漫插画创作:结合多风格 LoRA 生成人物、场景与概念草图,服务二次元、绘本与视觉开发。
中英文排版物料:处理菜单、活动页、贴纸与包装说明等含密集文字的本地化设计任务。
相关文章