Unlimited OCR 2是什么
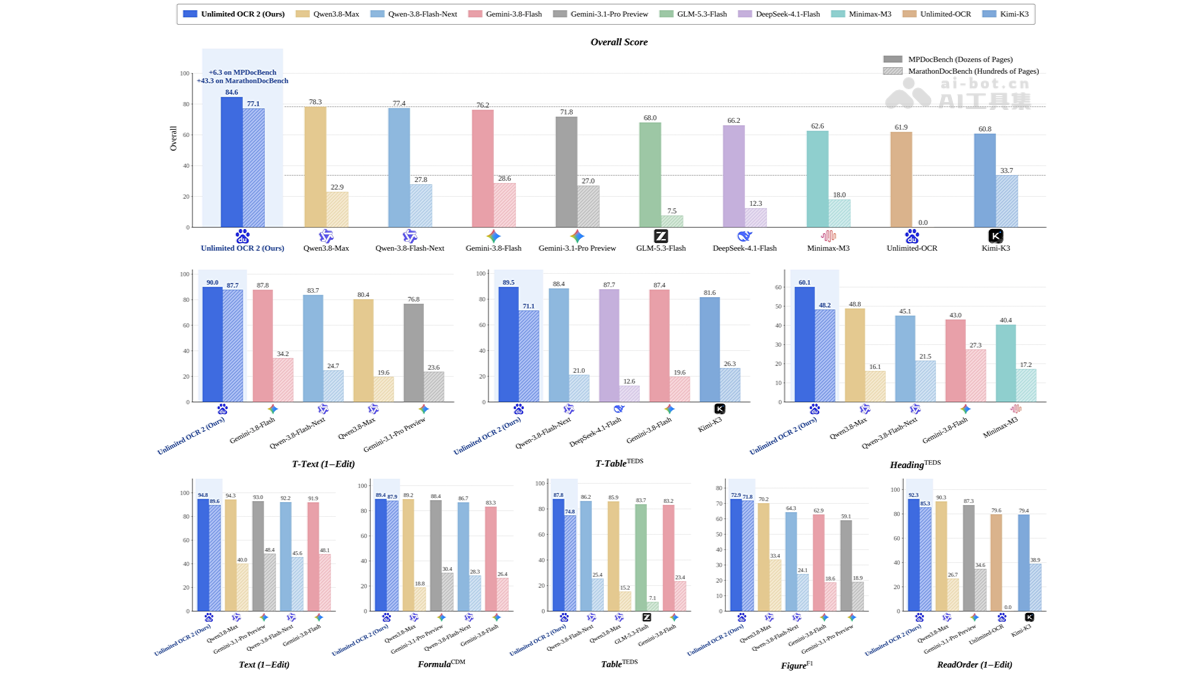
Unlimited OCR 2 是百度文心开源的端到端文档解析模型,支持任意页数超长文档解析,可一次性处理数千页书籍仍保持精度与效率。Unlimited OCR 2采用稀疏参考滑动窗口注意力机制与无限解码机制,降低长文档计算和显存开销,在 MPDocBench、MarathonDocBench 等基准上达 SOTA,推动 OCR 进入 3.0 时代。
Unlimited OCR 2的主要功能
任意页数解析:突破传统页数上限,支持一次性处理数千页级长文档。
长文档高精度理解:文档长度大幅增加时,保持较高解析精度与处理效率。
跨页信息关联:可回看前文、核对跨页内容,减少多页拼接造成的上下文断裂。
开源可用:代码与模型权重开源,并上线百度智能云、百度 AI 开放平台。
Unlimited OCR 2的技术原理
- SR-SWA 稀疏参考滑动窗口注意力:借鉴人类抄书时“专注当前页、必要时回看前文”的方式,由 Page Gate 把每个查询的视觉参考范围从整个文档缩小到相关页面,并建模跨页位置关系;引入得分最高的视觉 Token Buckets 捕捉长距离视觉依赖,避免 Full Attention 对全文档 token 的高冗余计算。
- Unlimited-Horizon Decoding 无限解码机制:针对超长文档解析中的计算与显存瓶颈优化解码过程,使模型在处理更多页数时不被上下文长度硬性卡住,支撑“任意页数”解析目标。
- 端到端长文档建模:不同于传统 OCR 的单页识别后拼接,也不同于上一代只扩展到连续数十页的 R-SWA,Unlimited OCR 2 将跨页选择、参考回看和当前页理解放入统一端到端框架,提升长文档解析的一致性与完整性。
- 效率与开销控制:SR-SWA 单步解码速度相比 Full Attention 提升 7 倍、相比上一代 R-SWA 提升 5.6 倍,核心收益来自用稀疏参考替代全局全量注意力。
微信关注回复“开源”,加入AI开源项目交流群
如何使用Unlimited OCR 2
选择入口:从 GitHub、Hugging Face 下载代码与权重本地部署。
准备文档:整理 PDF/扫描件/长文档,保证页面完整、清晰、方向正确。
上传或加载:在线入口直接上传文档;本地部署则配置环境并加载 Unlimited OCR 2 模型权重。
设置任务:按页面或 API 参数选择输出格式、解析范围、表格/版面识别等选项。
运行解析:提交任务,等待模型完成跨页理解、内容抽取与结构化生成。
核验结果:重点检查跨页标题、表格、公式、页码、引用和段落连续性。
导出集成:导出文本/Markdown/JSON,或通过 API 接入批处理与业务系统。
Unlimited OCR 2的核心优势
任意页数解析:突破传统 OCR 页数上限,可处理数千页级长文档。
长文档精度更稳:页数大幅增加时,仍能保持较高解析精度和效率。
跨页理解更强:可回看前文、关联跨页信息,减少拼接导致的上下文断裂。
计算效率更高:SR-SWA 用稀疏参考替代全量注意力,显著降低冗余计算。
显存开销更低:结合无限解码机制,缓解超长文档解析的显存压力。
基准表现领先:文中称在 MPDocBench、MarathonDocBench 等长文档基准达 SOTA。
Unlimited OCR 2的项目地址
- GitHub仓库:https://github.com/baidu/Unlimited-OCR
- HuggingFace模型库:https://huggingface.co/spaces/baidu/Unlimited-OCR-2
Unlimited OCR 2的同类竞品对比
| 维度 | 文心 Unlimited OCR 2 | MinerU |
|---|---|---|
| 核心定位 | 端到端 OCR/文档解析模型,主打任意页数、跨页上下文 | 文档解析框架,把 PDF/Office/图片转成结构化 Markdown/JSON |
| 长文档能力 | 文中称可一次性解析 3600+ 页书籍,核心是 SR-SWA + 无限解码 | 强项在版式、表格、公式、阅读顺序;长文档更多靠工程化批处理/结构化 |
| 输入格式 | 以图像/PDF 类文档解析为中心 | PDF、图片、Word、PPT、Excel、EPUB、OFD、HTML、CSV 等更广 |
| 输出形态 | 面向文档理解结果与长上下文解析 | 明确输出 Markdown/JSON,服务 RAG/Agent 工作流 |
| 技术机制 | Page Gate 缩小视觉参考范围,Token Buckets 抓长程依赖;SR-SWA 减少 Full Attention 冗余 | 版面检测、公式检测/识别、表格识别、OCR 等多模型流水线;VLM 后端可处理复杂页 |
| 性能口径 | MPDocBench 84.6、MarathonDocBench 77.1,文中称大幅领先;为厂商自报口径 | 3.4 称升级 PP-OCRv6 后 OCR 准确率约 +11%、OCR 处理约翻倍;同为项目方口径 |
| 部署与服务 | Transformers 快速测试,定制 SGLang 做服务 | CLI、Python SDK、HTTP API、WebUI、Router;可 CPU 低阶到 GPU/VLM 高阶 |
| 生态热度 | 一代曾冲榜,文中称 HF 下载破千万、GitHub 2.88 万 Star | 搜索结果显示约 69.7k GitHub stars,已被大量 RAG/Agent 流程采用 |
| 主要风险 | “任意页数/SOTA”需第三方复现;信任远程代码与定制 serving 有工程成本 | 许可证有附加条款,超大规模商用需核对 LICENSE;重文档 Pipeline 调优成本高 |
Unlimited OCR 2的应用场景
长书籍/文献解析:整本小说、教材、典籍快速数字化并保留跨页上下文。
研报与财报分析:一次性读入数百页研报、年报,抽取观点、指标与风险点。
法律与合规审查:处理法规汇编、合同卷宗、案卷材料,支持跨页条款关联。
档案与票据数字化:扫描档案、病历、历史资料批量转结构化文本入库。
RAG/知识库构建:把超长 PDF 解析成可检索内容,服务问答、搜索与智能体调用。
相关文章