DMAD是什么
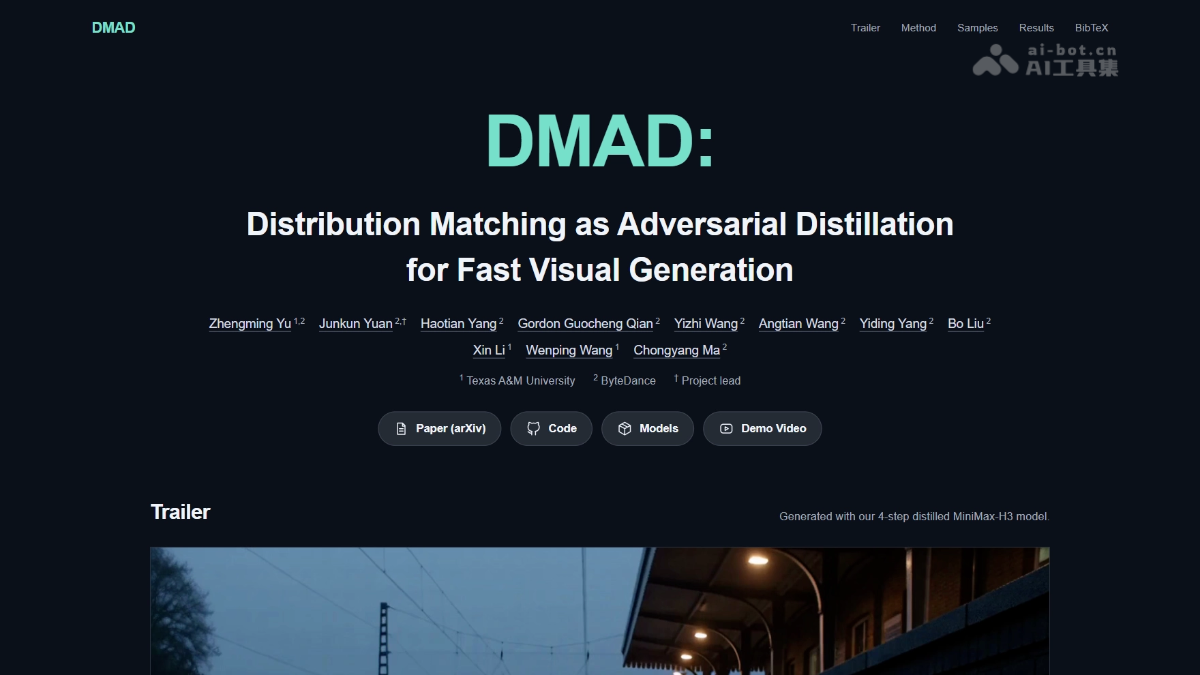
DMAD(Distribution Matching as Adversarial Distillation)是字节跳动与德州农工大学联合开源的少步蒸馏框架,用于加速扩散模型生成。DMAD训练二分类判别器直接学习目标分布与学生分布的差异,省去辅助扩散模型,将50步教师模型蒸馏为4步学生模型。已支持ImageNet、SDXL、Wan2.1及MiniMax-H3-33B,8GB显存可生成约5秒1344×768有声视频。
DMAD的主要功能
- 少步图像生成:将 ImageNet-64 的 EDM 模型蒸馏至 1 步采样,FID 低至 1.04,SDXL 仅需 4 步可文生图。
- 少步文生视频:把 Wan2.1-T2V-14B 蒸馏为 4 步学生模型,VBench 达 85.15。
- 联合音视频生成:将 MiniMax-H3-33B 的 50 步教师模型蒸馏为 4 步,输出 1344×768 视频与 32kHz 原生立体声音频。
- 消费级硬件支持:提供 8GB 显存 ComfyUI 工作流与低显存命令行推理,8GB 显卡可生成约 5 秒、12GB 约 15 秒有声视频。
- 训练与推理全开源:发布蒸馏方法、训练代码、推理脚本及多模型 LoRA 权重,覆盖命令行与 ComfyUI 两种使用方式。
DMAD的技术原理
- 分布匹配即对抗蒸馏:DMAD 为训练二分类判别器区分目标样本与学生样本,最优判别器的 logit 等于两分布的对数密度比,对其输入求梯度即得 score 差,直接给出学生的修正方向,省掉辅助 score 拟合模型。
- 共享骨干、双头判别器:判别器采用单一共享特征骨干、两个判别头,教师头区分教师样本与学生样本,真实数据头区分真实样本与学生样本,均用二元交叉熵训练;学生用两个 logit 的加权线性损失更新,更新时冻结判别器参数但保留梯度回传。
- 噪声区间动态加权:教师样本与真实数据的分布差异随噪声水平变化,DMAD 用真实数据头在两类样本上的平均 logit 差作为经验信号,以 0.99 衰减的指数移动平均追踪各噪声区间,差距小的区间获得更高教师权重,归一化后参与学生损失。
- 离线教师样本加速训练:教师只提供预生成并缓存的样本,训练时无需在线调用教师。4 卡 H200、MiniMax-H3 rank-128 LoRA 配置下,每次学生更新及关联判别器更新耗时从 818.1 秒降至 233.3 秒,实现约 3.51 倍训练加速。
微信关注回复“开源”,加入AI开源项目交流群
如何使用DMAD
克隆仓库:
git clone https://github.com/Yzmblog/DMAD.git并进入项目目录。创建环境:用 conda 创建 Python 3.12 环境并激活。
安装依赖:按官方固定版本安装 PyTorch 2.11.0(cu126)、torchvision、torchaudio,再执行
pip install -r requirements.txt和pip install -U modelscope-hub。准备硬件:确保有支持 CUDA 的 NVIDIA 显卡,并预留约 64GB 系统内存与 170GB 磁盘空间。
下载基础模型:通过
modelscope download MiniMax/MiniMax-H3下载 MiniMax-H3 基础模型。下载蒸馏权重:从魔搭下载 DMAD 的 4 步 LoRA。
命令行推理:运行
inference.py,指定模型路径、LoRA、提示词文件、--steps 4、--height 768 --width 1344,按显存选择--low-vram 8或--low-vram 12。查看输出:输出目录包含 0000.mp4、提示词 txt 和 settings.json,跑通后可替换为自己的提示词文件。
DMAD的核心优势
推理大幅提速:将 50 步教师模型蒸馏为 4 步学生模型,去噪迭代减少 92% 以上,同时保持接近教师的生成质量。
训练效率更高:判别器直接学习分布差异,省去辅助扩散模型,4 卡 H200 上训练更新加速约 3.51 倍。
生成质量领先:ImageNet-64 一步生成 FID 达 1.04,优于 DMD2、SiDA 等方法;人类评估中对 DMD2 总体偏好率 79.1%、对 rCM 达 84.6%。
覆盖多模态全场景:同一框架统一支持图像、文生视频和联合音视频生成。
DMAD的项目地址
- 项目官网:https://yzmblog.github.io/projects/DMAD/
- GitHub仓库:https://github.com/Yzmblog/DMAD
- HuggingFace模型库:https://huggingface.co/ZhengmingYu/DMAD
- arXiv技术论文:https://arxiv.org/pdf/2610.02188
DMAD的同类竞品对比
| 对比维度 | DMAD | DMD2 |
|---|---|---|
| 技术路线 | 训练二分类判别器直接学习目标/学生分布差异,无需辅助扩散模型 | 需教师 score + 辅助扩散模型持续拟合学生 score,再求差更新 |
| 判别器结构 | 共享特征骨干 + 双判别头(教师头 + 真实数据头),噪声区间动态加权 | 单一判别目标,无分噪声区间加权机制 |
| ImageNet-64(1步)FID | 1.04(+projected discriminator)/ 1.24 | 1.28(加长训练)/ 1.51(标准) |
| 人类偏好(MiniMax-H3) | 总体偏好率 79.1%(vs DMD2),音频质量偏好 87.9% | 作为被比较方落败 |
| 训练开销 | 教师样本离线缓存,4卡H200每次更新 233.3s | 需在线调用教师,同样配置 818.1s(慢约3.51倍) |
| 教师调用方式 | 仅使用预生成缓存样本 | 训练中持续在线采样 |
| 开源支持 | 图像/视频/音视频全模态,含 ComfyUI 工作流 | 主要面向图像蒸馏 |
DMAD的应用场景
短视频内容创作:4 步生成带原生音频的 5–15 秒视频,创作者在 8GB 消费级显卡上即可快速产出社交媒体素材,大幅降低制作成本。
广告与营销素材生成:品牌方可基于提示词批量生成产品展示、场景化视频,配合高质量音频输出,缩短广告素材从构思到成品的周期。
影视预演与概念设计(Previs):导演和美术团队用少步蒸馏快速生成镜头预演、氛围参考和分镜草样,加速前期创意迭代。
游戏与动画资产制作:生成角色动画、场景概念图和动态背景素材,辅助独立游戏工作室和小型动画团队降低资产生产成本。
相关文章